Methodik
Diese 8 technischen Voraussetzungen machen Ihre Website GEO-ready
Was Entwickler und Website-Agenturen vor dem Go-Live beachten müssen, damit ChatGPT, Google AI Overviews, Copilot, Claude und Perplexity eine Website erreichen und maschinell lesen können.
Eine Website kann fachlich hervorragende Inhalte haben und trotzdem schlechte Voraussetzungen für Sichtbarkeit in KI-Antworten mitbringen.
Der Grund liegt oft nicht im Content, sondern eine Ebene tiefer: Ein relevanter Crawler wird blockiert. Eine Firewall liefert ihm eine Prüfseite. Der Hauptinhalt erscheint erst nach clientseitigem JavaScript. Ein noindex aus der Staging-Umgebung landet versehentlich auf der Live-Site. Oder ein Canonical zeigt auf die falsche URL.
Viele dieser Fehler entstehen bereits beim Bau einer Website.
Deshalb sollte technische GEO-Readiness nicht erst nach dem Relaunch geprüft werden. Sie gehört in die Anforderungen für Entwicklung, Hosting und Deployment.
Unser technischer Leitfaden beruht auf der Kriterienbibliothek v2.1 unseres technischen GEO-Audits. Für den Go-Live lassen sich daraus acht Voraussetzungen ableiten, die besonders wichtig sind. Der Leitfaden trennt dabei technische Erreichbarkeit ausdrücklich von Content-Qualität und tatsächlicher KI-Sichtbarkeit.
Was muss eine GEO-ready Website technisch können?
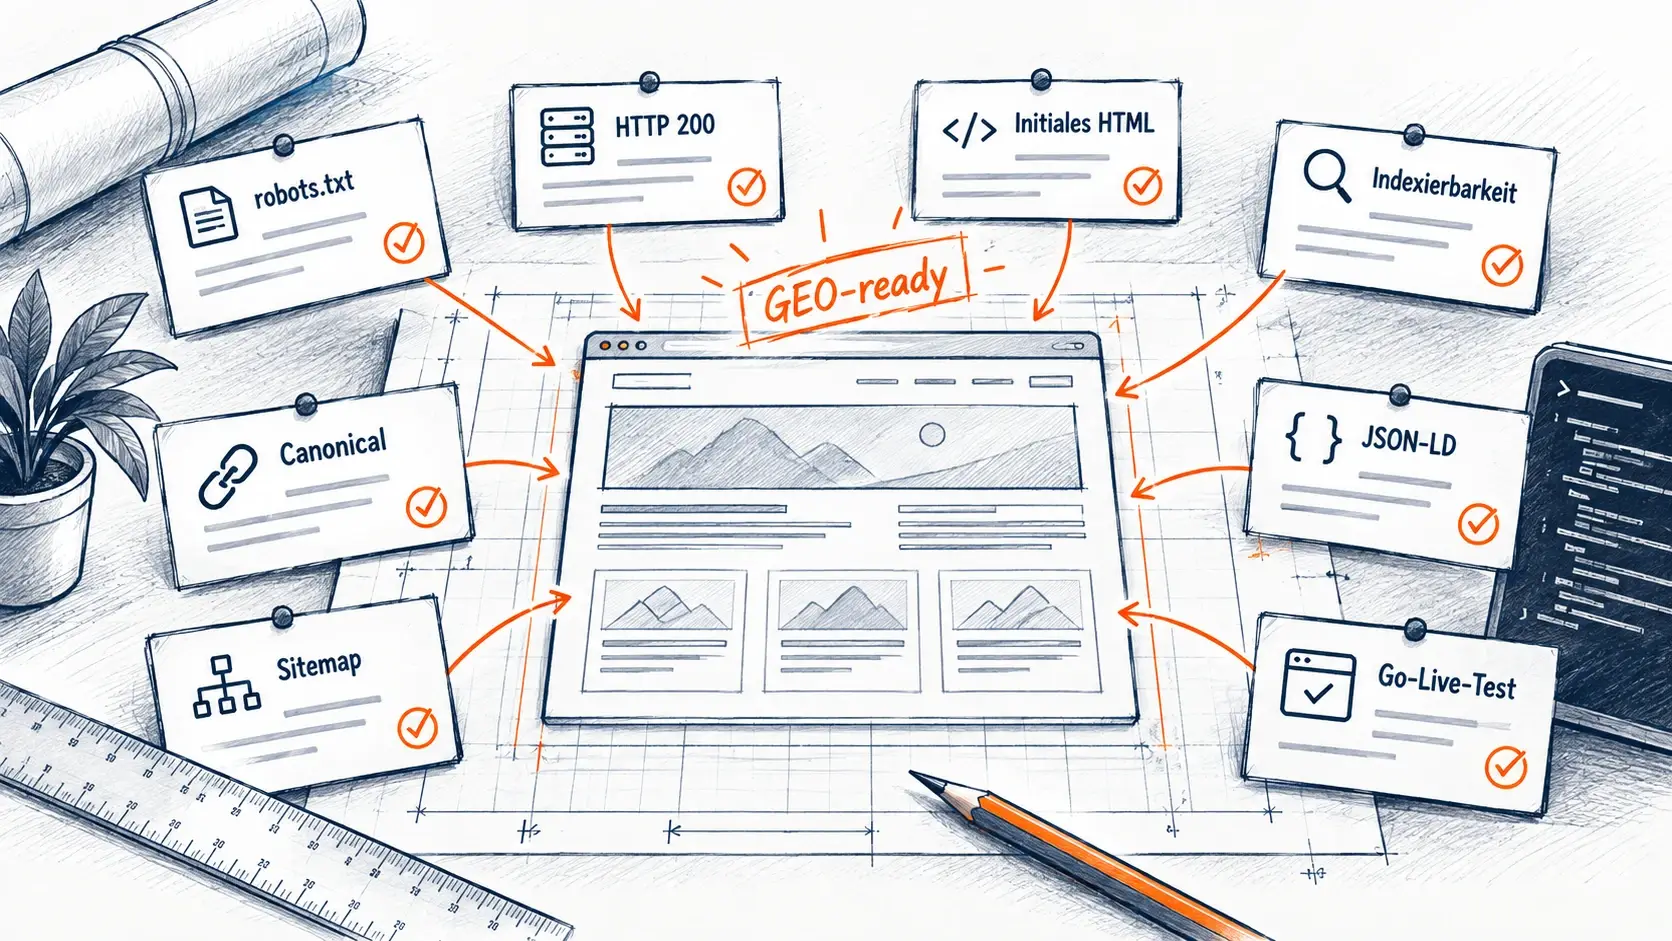
Vor dem Go-Live sollten acht Dinge stimmen:
- Relevante Suchmaschinen- und KI-Retrieval-Crawler dürfen zugreifen.
- Hosting, CDN, Firewall und Sicherheitssoftware liefern diesen Crawlern die Website tatsächlich aus.
- Der zentrale Inhalt steht bereits im initial ausgelieferten HTML.
- Seiten, die als Quelle dienen sollen, sind indexierbar und nicht durch
noindexodernosnippetausgeschlossen. - Canonicals zeigen auf die richtige öffentliche URL.
- Strukturierte Daten sind valide und stimmen mit dem sichtbaren Inhalt überein.
- Die Sitemap wird sauber erzeugt und in der
robots.txtreferenziert. - Nach dem Go-Live werden Staging-Sperren entfernt und die Zugriffswege tatsächlich getestet.
Technik ist die Vorbedingung, nicht das Ergebnis. Eine technisch einwandfreie Website wird dadurch nicht automatisch in einer KI-Antwort genannt. Eine technisch versperrte Website schafft sich aber unnötig schlechte Voraussetzungen.
Was technisch GEO-ready bedeutet
Technische GEO-Readiness beantwortet zunächst nur eine Frage: Kann ein relevantes KI- oder Suchsystem den Inhalt einer Website erreichen und technisch verarbeiten?
Dafür unterscheiden wir drei Dimensionen.
Core Visibility: Erreichen die Crawler die Inhalte und können sie sie lesen?
Platform Coverage: Über welchen technischen Weg können Google, Microsoft, OpenAI, Anthropic oder Perplexity die Website erreichen?
Technical Readiness: Sind Struktur, Markup, Sprache, Datumsangaben und Sitemap maschinenlesbar und widerspruchsfrei?
Diese Trennung ist wichtig. Denn ein Problem mit dem Crawler-Zugang ist etwas anderes als ein schlechtes JSON-LD-Markup. Und beides ist wiederum etwas anderes als die Frage, ob eine Marke in einer ChatGPT-Antwort tatsächlich genannt wird.
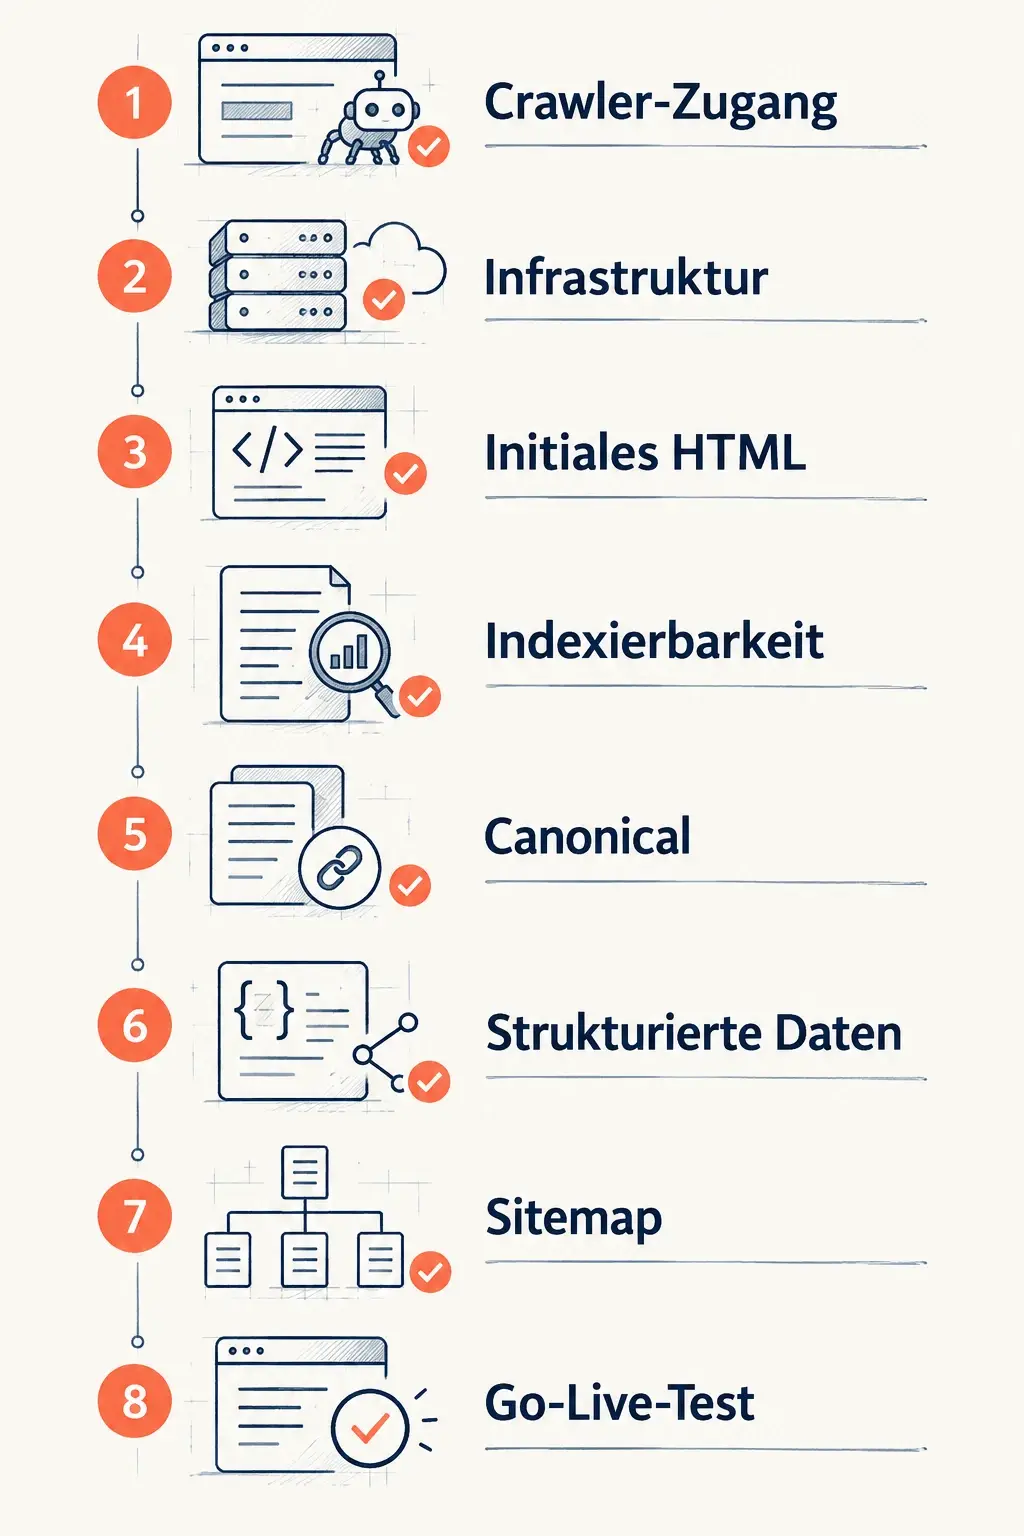
1. Crawler-Zugang richtig steuern
Die robots.txt ist eine der Stellen, an denen eine Website KI-Sichtbarkeit unbeabsichtigt verhindern kann.
Für eine normale öffentliche Website kann die technische Basis sehr einfach aussehen:
User-agent: *
Allow: /

Sitemap: https://www.example.com/sitemap.xml
Wichtig ist allerdings nicht nur, was erlaubt wird. Entscheidend ist auch, welcher Crawler für welchen Zweck zuständig ist.
GPTBot und OAI-SearchBot sind beispielsweise nicht dasselbe. Der eine dient dem Modelltraining, der andere dem Search- beziehungsweise Retrievalpfad von OpenAI. Wer das Training ausschließen möchte und deshalb pauschal alle OpenAI-Crawler sperrt, kann unbeabsichtigt gleichzeitig einen relevanten Zugriffsweg für aktuelle Antworten schließen.
Ähnliche Unterschiede existieren bei anderen Anbietern. Deshalb sollte eine Entscheidung gegen Modelltraining nicht als pauschales Blockieren aller KI-Bots umgesetzt werden.
2. Infrastruktur: Erlaubt heißt noch nicht erreichbar
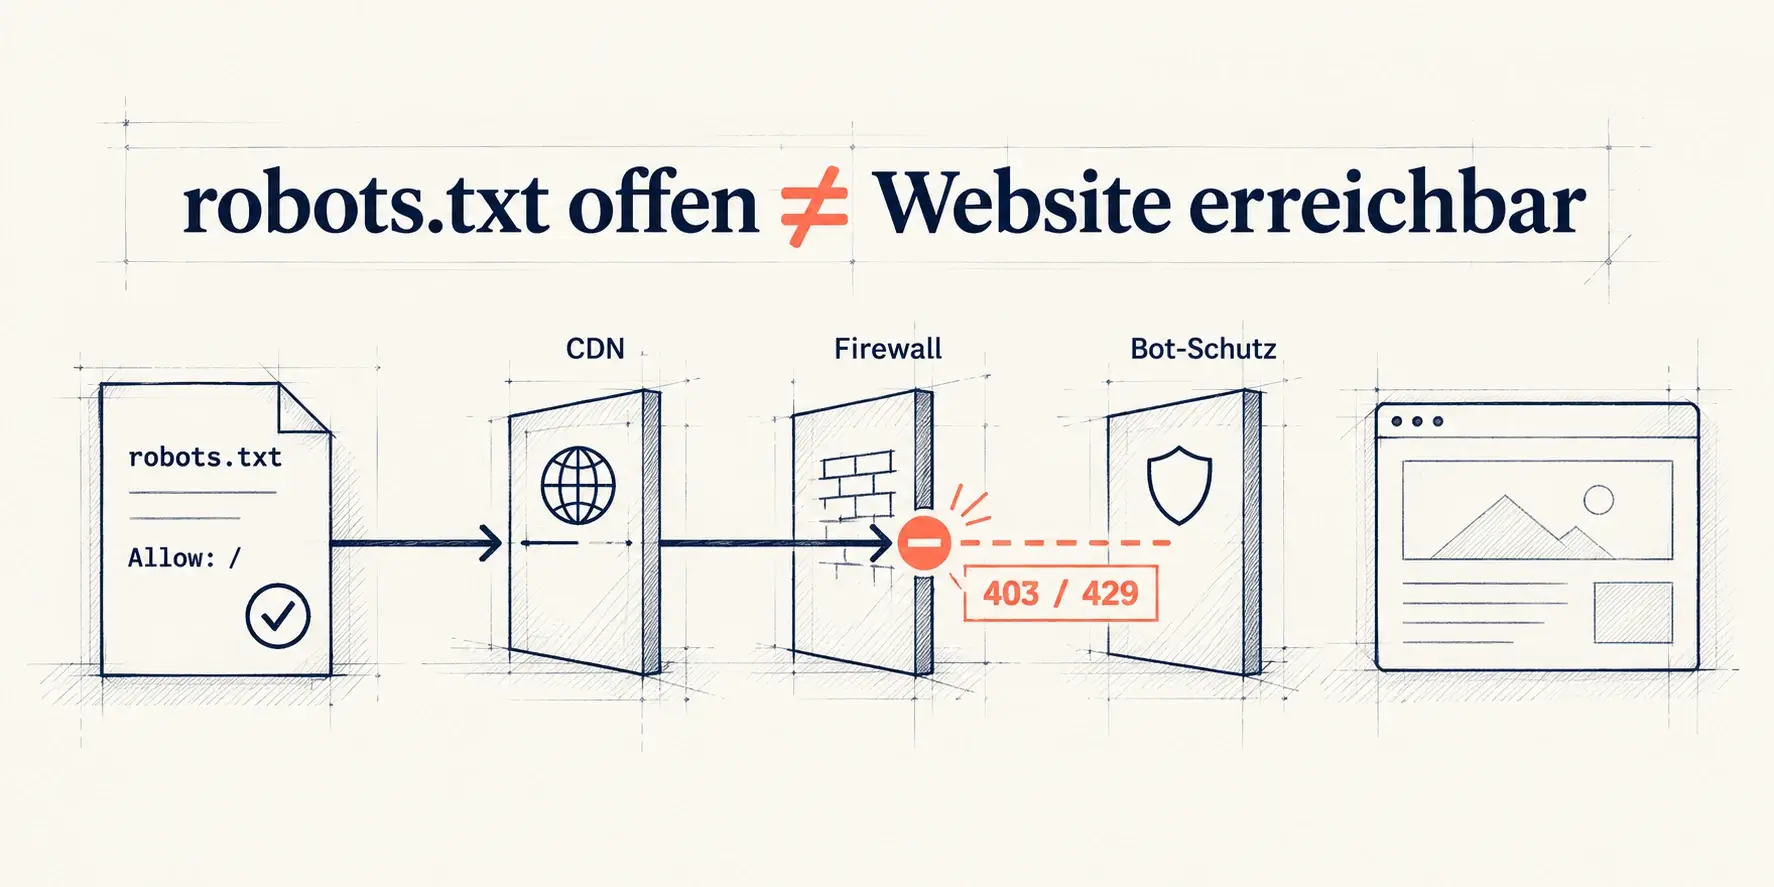
Eine offene robots.txt ist keine Messung.
Zwischen einem Crawler und der eigentlichen Website liegen häufig weitere Systeme: Hosting, CDN, Web Application Firewall, Bot-Schutz, Sicherheitsplugins, Rate-Limits oder geografische Zugriffsbeschränkungen.
Die robots.txt kann einen Crawler ausdrücklich zulassen und der Server trotzdem mit 403, dauerhaft mit 429 oder mit einer Challenge-Seite antworten. Wir nennen das eine stille Sperre.
Das ist besonders tückisch, wenn die vorgeschaltete Prüfseite selbst mit HTTP 200 ausgeliefert wird. Ein oberflächlicher Statuscheck sieht dann erfolgreich aus, obwohl der eigentliche Content nie beim Crawler ankommt.
Genau deshalb müssen zwei Ebenen getrennt geprüft werden: Darf der Bot laut robots.txt zugreifen? Und bekommt er den echten Seiteninhalt tatsächlich ausgeliefert?
3. Der Hauptinhalt gehört ins initiale HTML
Moderne Websites laden immer mehr Inhalte clientseitig. Für den Nutzer im Browser ist das häufig unproblematisch. Für automatisierte Systeme ist es unnötiges Risiko.
Der zentrale Inhalt einer öffentlichen Seite sollte deshalb bereits serverseitig oder statisch im ausgelieferten HTML vorhanden sein. Dazu zählen insbesondere Haupttitel, Haupttext, Preise, Öffnungszeiten, Leistungsumfang, Adressen, technische Daten, Navigation und wichtige interne Links.
Ein React-, Vue- oder anderer JavaScript-Stack ist deshalb nicht grundsätzlich ein GEO-Problem. Die entscheidende Frage lautet: Ist die wichtige Information schon da, bevor clientseitiges JavaScript ausgeführt wird?
4. Indexierbarkeit Seite für Seite sicherstellen
Nicht nur die Startseite muss erreichbar sein. Jede URL, die später als Quelle dienen soll, sollte unter ihrer endgültigen öffentlichen Adresse sauber funktionieren.
HTTP 200. Die Seite sollte direkt mit dem erwarteten Inhalt antworten.
Kein noindex. Weder als Meta-Tag noch als X-Robots-Tag.
Kein unbeabsichtigtes nosnippet, wenn Inhalte für Such- und generative Antwortfunktionen verwendet werden sollen.
Keine Zugangswand vor dem Content. Ein Cookie-Banner darf über dem Inhalt liegen. Der eigentliche Text sollte aber nicht erst nach Zustimmung geladen werden.
Einer der häufigsten Fehler entsteht beim Wechsel von Staging auf Produktion: Die Testumgebung war korrekt mit noindex oder Zugriffsbeschränkungen geschützt, und beim Deployment landet diese Einstellung versehentlich mit auf der Live-Domain. Deshalb gehören diese Einstellungen an eine Umgebungsvariable und anschließend in den Go-Live-Test.
5. Canonicals müssen die richtige Seite benennen
Ein Canonical wirkt unspektakulär, sendet aber eine klare technische Botschaft: Welche URL ist die maßgebliche Version dieses Inhalts?
Problematisch wird es, wenn eine öffentliche Unterseite auf die Startseite, eine Staging-Domain, eine Parameter-URL, eine andere Sprachversion oder eine andere Unterseite canonicalisiert wird.
Soll eine Seite selbst als Quelle gefunden und verwendet werden, sollte ihr Canonical dieser Absicht nicht widersprechen. Ein fehlendes selbstreferenzierendes Canonical ist nicht automatisch ein Blocker. Ein Canonical auf die falsche Seite ist wesentlich problematischer.
6. Strukturierte Daten: sauber statt möglichst viel
Strukturierte Daten sind kein magischer GEO-Rankingfaktor. Für die Behauptung, mehr Schema-Markup führe automatisch zu mehr KI-Zitaten, gibt es keinen belastbaren Nachweis.
Trotzdem sind strukturierte Daten sinnvoll. Sie helfen dabei, zentrale Entitäten und Fakten maschinenlesbar eindeutig zu beschreiben. Für eine Unternehmenswebsite bedeutet das typischerweise WebSite, Organization und bei Bedarf spezifischere Typen wie Product, Article, Event, Person oder LocalBusiness.
Wichtiger als möglichst viel Markup sind drei Dinge: syntaktisch valide, inhaltlich korrekt, deckungsgleich mit dem sichtbaren Text.
Ein Preis, ein Datum oder eine Adresse sollte nicht ausschließlich im JSON-LD vorkommen. Und wenn eine Angabe im Markup steht, darf sie dem sichtbaren Seiteninhalt nicht widersprechen.
7. Sitemap sauber und automatisch erzeugen
Eine Sitemap garantiert keine Sichtbarkeit. Sie ist aber ein sinnvoller technischer Weg, Suchsystemen die verfügbaren URLs und deren Änderungen strukturiert mitzuteilen.
Eine gute Sitemap sollte automatisch erzeugt werden, in der robots.txt referenziert sein, nur kanonische öffentliche URLs enthalten, keine Fehlerseiten und keine noindex-Seiten führen und sinnvolle lastmod-Werte verwenden.
Gerade beim letzten Punkt lohnt sich Zurückhaltung. Das Änderungsdatum sollte sich ändern, wenn sich der relevante Inhalt verändert hat. Nicht jedes technische Deployment ist automatisch eine inhaltliche Aktualisierung.
Bei mehrsprachigen Websites kommen korrekte hreflang-Verweise hinzu.
8. Der Go-Live-Test gehört zum Deployment
Technische Readiness ist nicht abgeschlossen, wenn der Code gemerged wurde. Sie ist abgeschlossen, wenn die Live-Domain unter realistischen Bedingungen geprüft wurde.
Nach dem ersten Deployment sollten deshalb mindestens folgende Dinge kontrolliert werden: Staging-Sperren entfernt, robots.txt korrekt, wichtige Crawler erhalten HTTP 200 und echten Content, kein versehentliches noindex oder nosnippet, Canonical korrekt, Sitemap live, Hauptinhalt im ausgelieferten HTML, Google Search Console und Bing Webmaster Tools eingerichtet.
Zusätzlich existieren Einstellungen, die sich nicht aus dem HTML oder der robots.txt ablesen lassen. Dazu gehören beispielsweise Einstellungen für generative Suchfunktionen in der Google Search Console. Das ist ein gutes Beispiel dafür, warum technische GEO-Readiness nicht ausschließlich durch Quellcode-Review geprüft werden kann.
KI-Crawler ist nicht gleich KI-Crawler
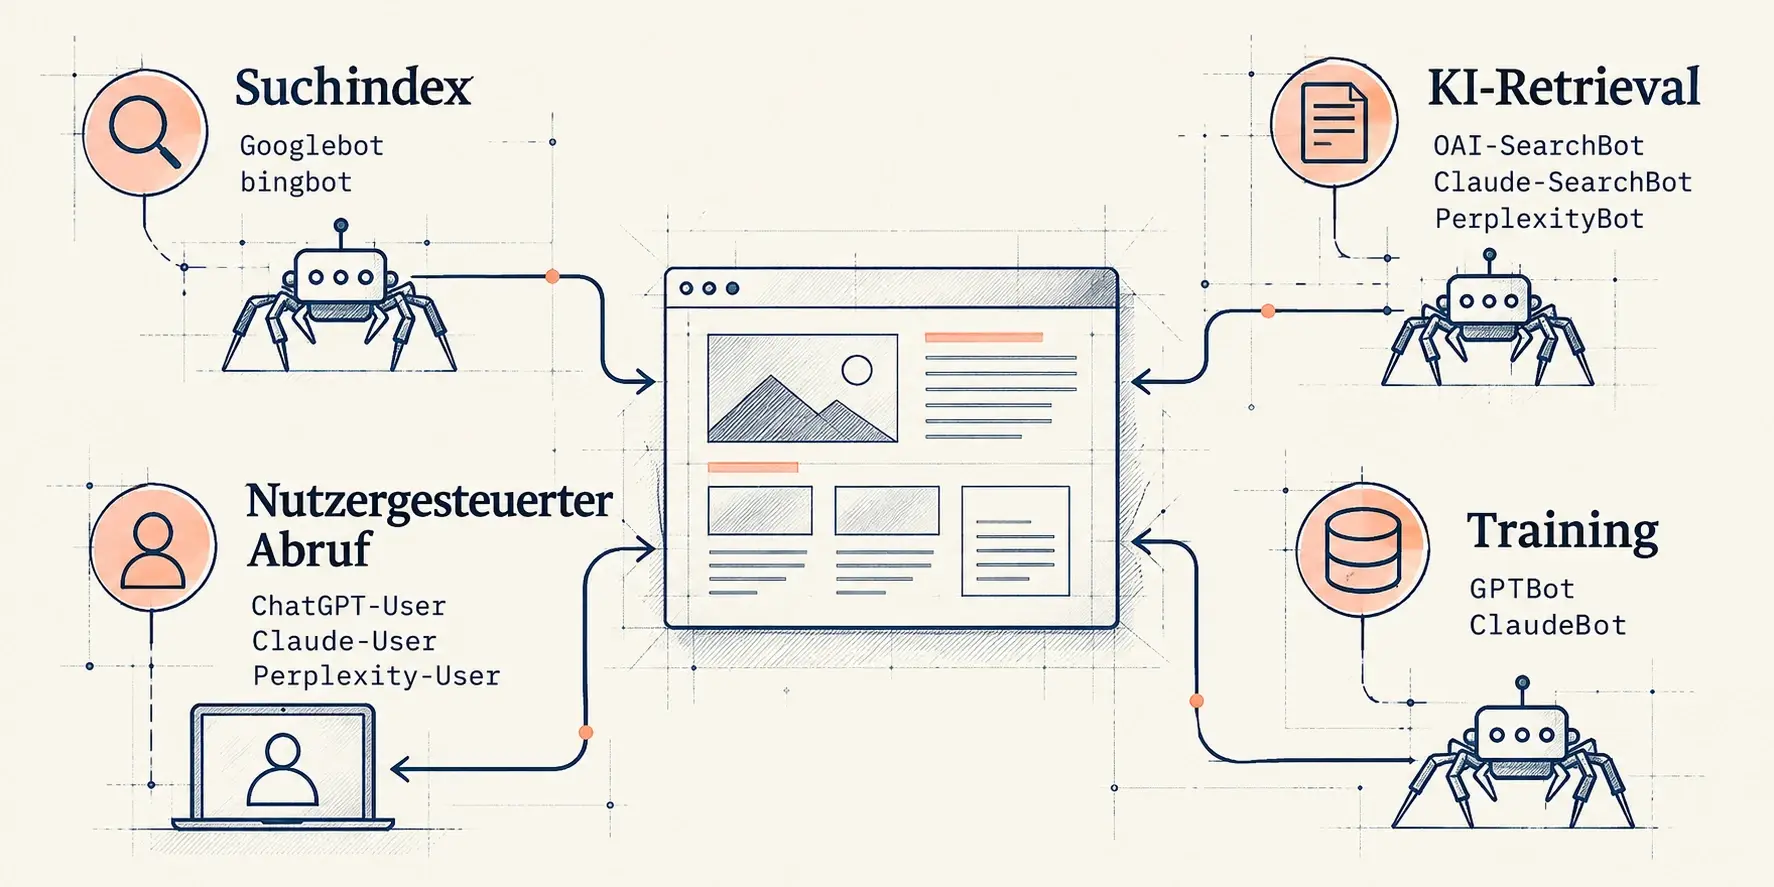
Der Begriff „KI-Crawler” verschleiert einen wichtigen Unterschied. Crawler können mindestens vier verschiedene Aufgaben erfüllen.
Suchindex-Crawler bauen Suchmaschinenindizes auf. Dazu gehören beispielsweise Googlebot und bingbot.
KI-Retrieval-Crawler sammeln beziehungsweise indexieren Quellen für KI-Antwortsysteme. Beispiele sind OAI-SearchBot, Claude-SearchBot und PerplexityBot.
Nutzergesteuerte Abrufe entstehen, wenn ein Nutzer einen aktuellen Webabruf auslöst. Dazu gehören unter anderem ChatGPT-User, Claude-User oder Perplexity-User.
Trainings-Crawler sammeln Daten für Modelltraining.
Deshalb ist ein Disallow nicht einfach ein Disallow. Die Konsequenz hängt davon ab, welchen technischen Pfad man damit sperrt.
Was derzeit keine Go-Live-Priorität hat
Im GEO-Umfeld entstehen laufend neue Dateien, Protokolle und vorgeschlagene Standards. Das prominenteste Beispiel ist llms.txt.
Wir behandeln die Datei derzeit nicht als Go-Live-kritisch. Der Grund ist einfach: Für einen Sichtbarkeitseffekt in großen KI-Antwortsystemen liegt nach unserem derzeitigen Faktenstand kein belastbarer Nachweis vor.
Im Leitfaden zitieren wir eine Ahrefs-Auswertung von 137.210 Domains. 97 Prozent der vorhandenen llms.txt-Dateien erhielten im untersuchten Zeitraum keinen Abruf. Google hat zudem erklärt, dass die Datei für Sichtbarkeit nicht erforderlich ist.
Das bedeutet nicht, dass llms.txt grundsätzlich nutzlos ist. Es bedeutet: Wenn Googlebot, OAI-SearchBot oder PerplexityBot an der Firewall hängen oder der Hauptcontent nur clientseitig existiert, ist llms.txt nicht das Problem, das zuerst gelöst werden sollte.
Fünf Checks vor dem Go-Live
Viele der wichtigsten Punkte lassen sich in wenigen Minuten von der Kommandozeile prüfen.
1. robots.txt lesen
curl -s https://www.example.com/robots.txt2. Serverantwort mit verschiedenen User-Agents vergleichen
for ua in Googlebot bingbot Applebot OAI-SearchBot ChatGPT-User \
 Claude-SearchBot Claude-User PerplexityBot Perplexity-User \
 MistralAI-Index DuckAssistBot; do
 printf '%-18s ' "$ua"
 curl -s -o /dev/null -w '%{http_code} %{size_download} Bytes\n' \
 -A "$ua" https://www.example.com/
 sleep 5
done
Eine deutlich abweichende Antwortgröße ist ein Hinweis auf eine Block- oder Prüfseite. Sie ist noch kein Beweis.
3. Antwortheader prüfen
curl -s -D - -o /dev/null https://www.example.com/ \
 | grep -iE 'x-robots-tag|last-modified|server|via|retry-after'
4. Prüfen, ob ein Text ohne JavaScript im HTML steht
curl -s https://www.example.com/ \
 | grep -F -c 'Ihr Textausschnitt'
5. Meta-Direktiven und Canonical prüfen
curl -s https://www.example.com/ \
 | grep -iE "name=['\"](robots|bingbot)['\"]|rel=['\"]canonical['\"]"
Wichtig: Das Setzen eines User-Agents simuliert den echten Crawler nicht vollständig. Wenn Firewall-Regeln zusätzlich IP-Netze oder andere Merkmale prüfen, können nur Logs und die jeweiligen Webmaster-Werkzeuge Klarheit schaffen.
Ist Ihre Website technisch für KI-Systeme erreichbar?
Die acht Punkte lassen sich auch ohne Kommandozeile prüfen. Unser kostenloser GEO-Check schickt vierzehn echte KI-Crawler-Kennungen gegen Ihre Startseite und prüft unter anderem Crawler-Zugang, technische Blockaden, serverseitige Lesbarkeit, Indexierbarkeit, maschinenlesbare Struktur und Sitemap. Das Ergebnis steht nach rund 25 Sekunden auf dem Bildschirm, ohne Anmeldung.
Vom Schnellcheck zum vollständigen Audit
Die acht Voraussetzungen sind das Minimum Setup.
Unser vollständiges technisches GEO-Audit geht darüber hinaus und prüft 23 Gruppen über die drei Dimensionen Core Visibility, Platform Coverage und Technical Readiness. Darunter fallen beispielsweise interne Verlinkung, semantische Listen und Tabellen, Alternativtexte, Entitätsidentifikation, Datumsangaben, Sprache, hreflang, Sitemap und plattformspezifische Crawlerpfade.
Dabei unterscheiden wir drei Dringlichkeiten. P0: zentraler Crawl-, Indexierungs-, Retrieval- oder Zitierpfad beeinträchtigt. P1: wesentlicher technischer Mangel. P2: technische Optimierung.
Der vollständige technische Leitfaden
Sie bauen eine neue Website oder planen einen Relaunch?
Unser Leitfaden „Technisch GEO-ready ab dem ersten Deployment” geht deutlich tiefer als dieser Artikel. Auf 22 Seiten enthält er unter anderem die vollständige Crawler-Systematik, konkrete robots.txt-Beispiele, die Plattformmatrix, strukturierte Daten, die 23-Punkte-Go-Live-Checkliste, Terminal-Tests, die Prioritäten P0, P1 und P2 sowie die aktuelle Einordnung von llms.txt und neuen Signalen.
Danke. Der Leitfaden ist auf dem Weg zu Ihnen — sehen Sie in Ihrem E-Mail-Postfach nach. Falls nichts ankommt, prüfen Sie bitte auch den Spam-Ordner.
Was technische GEO-Readiness nicht leisten kann
Das ist die wichtigste Einschränkung dieses Artikels.
Wenn alle acht Punkte erfüllt sind, bedeutet das nicht, dass diese Website von ChatGPT zitiert wird. Technische GEO-Readiness beantwortet nur: Kann ein System die Website erreichen und lesen?
Danach kommen zwei andere Fragen. Sind die Inhalte so geschrieben und strukturiert, dass sie als Quelle geeignet sind? Und wird die Marke bei relevanten Nutzer-Prompts tatsächlich genannt oder zitiert?
Das erste ist eine Content-Frage. Das zweite lässt sich nur durch systematische Sichtbarkeitsmessung beantworten. Wie Empfehlungen in KI-Systemen überhaupt zustande kommen, haben wir in einem eigenen Beitrag beschrieben: Wie KI-Empfehlungen tatsächlich entstehen. Wer wissen will, ob die eigene Marke dort vorkommt, misst das mit unserer KI-Sichtbarkeits-Analyse.
Technische Bereitschaft ist notwendig, aber nicht hinreichend.
Häufige Fragen
Muss ich GPTBot erlauben, damit meine Website in ChatGPT sichtbar werden kann?
Nein. Trainings-Crawler und Retrieval- beziehungsweise Search-Crawler haben unterschiedliche Aufgaben. Für die technische Zugänglichkeit aktueller Webinhalte ist insbesondere der jeweilige Search- beziehungsweise Retrievalpfad relevant. Deshalb sollte ein Trainings-Opt-out nicht als pauschale Sperre aller Crawler eines Anbieters umgesetzt werden.
Ist JavaScript schlecht für GEO?
Nein. Entscheidend ist, ob der zentrale Inhalt der Seite bereits im initial ausgelieferten HTML vorhanden ist. Interaktive JavaScript-Komponenten können zusätzlich verwendet werden.
Reicht eine offene robots.txt?
Nein. Hosting, CDN, Firewall oder Bot-Schutz können einen Crawler unabhängig von der robots.txt blockieren.
Braucht eine GEO-ready Website eine llms.txt?
Nach unserem derzeitigen Faktenstand nicht. Für einen Sichtbarkeitseffekt in großen KI-Antwortsystemen liegt kein belastbarer Nachweis vor. Die klassischen technischen Grundlagen haben höhere Priorität.
Garantiert ein gutes technisches Audit mehr Erwähnungen in ChatGPT?
Nein. Ein technisches Audit bewertet technische Voraussetzungen. Ob eine Marke tatsächlich genannt und zitiert wird, muss separat über relevante Prompts und KI-Systeme gemessen werden.
Quellen und Faktenstand
Faktenstand: 6. Oktober 2026.
Grundlage dieses Artikels ist unser Leitfaden „Technisch GEO-ready ab dem ersten Deployment”, Kriterienbibliothek v2.1 des technischen GEO-Audits. Der Leitfaden wertet unter anderem Dokumentationen von Google, Microsoft und Bing, OpenAI, Anthropic, Apple, Amazon und weiteren Anbietern sowie RFC 9309 und schema.org aus. Zentrale Anbieterangaben wurden am 6. Oktober 2026 erneut abgeglichen.
Die genannte Auswertung zu llms.txt stammt von Ahrefs und umfasst 137.210 Domains. Sie ist eine Anbieterauswertung ohne veröffentlichte Rohdaten.