Methodik
KI-Sichtbarkeit messen 2026: Welche Methode passt?
Manuelle Messung, Messwerkzeug im Abo und API-Abfrage im Vergleich
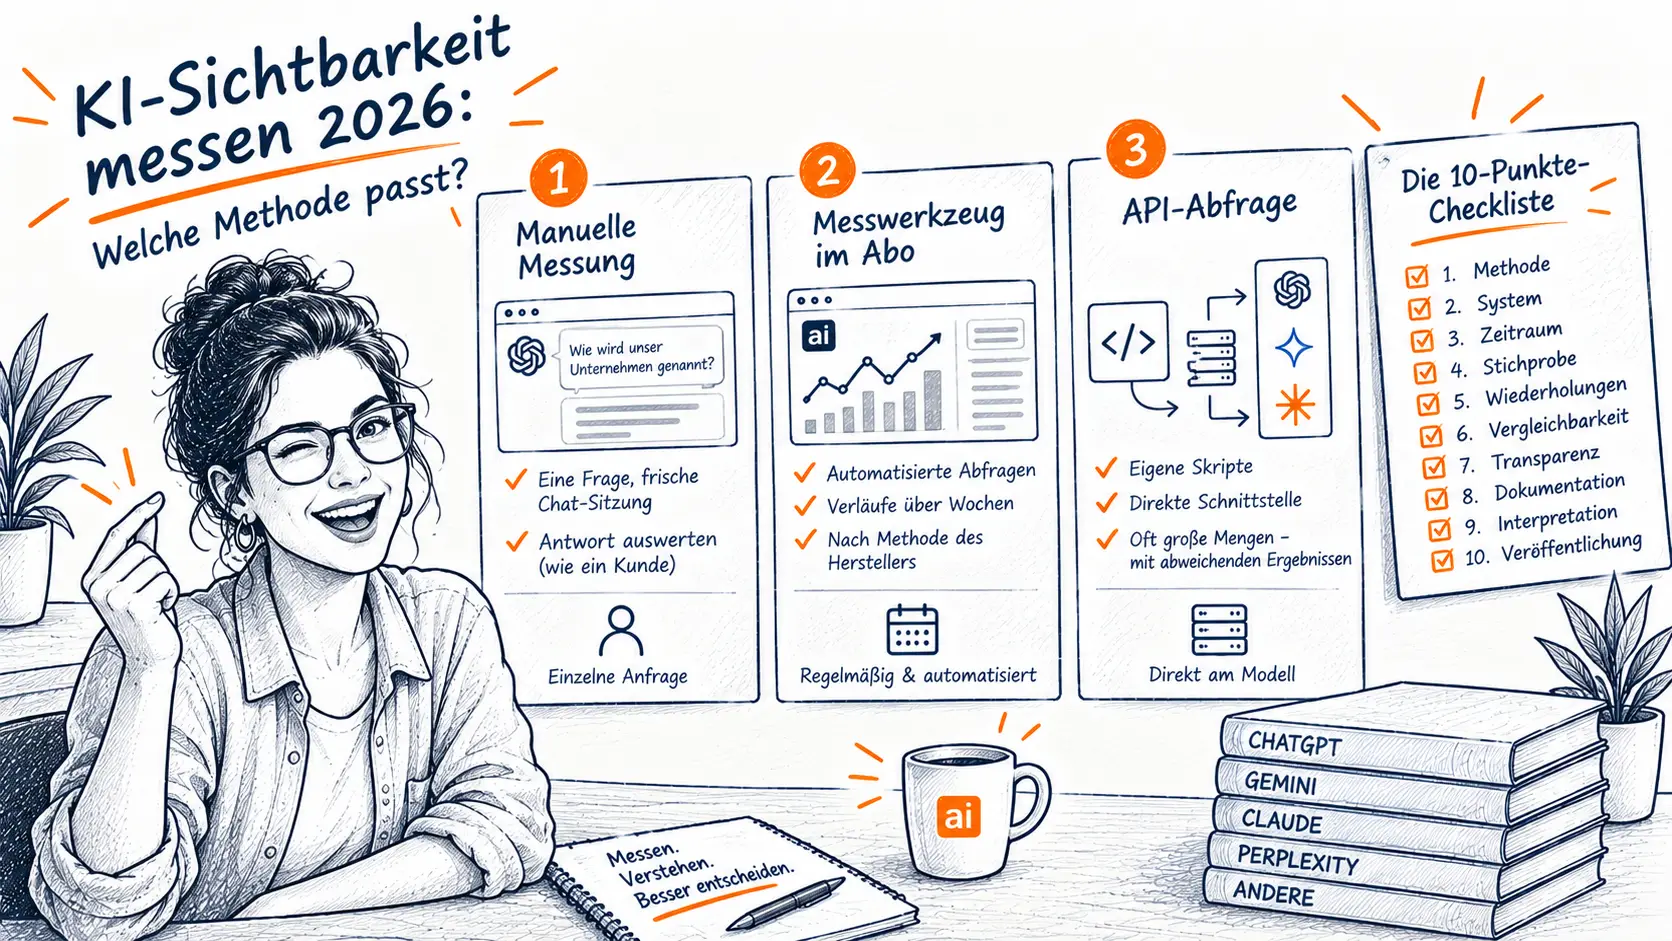
Sie geben in ChatGPT eine Frage ein, wie ein Kunde sie stellen würde, und lesen die Antwort. Taucht Ihr Unternehmen auf? Dann stellt sich die nächste Frage: Ist das nun Zufall, oder lässt sich daraus ableiten, wie gut Ihr Marketing in den vergangenen Jahren gearbeitet hat?
Die ehrliche Antwort: KI-Sichtbarkeit lässt sich messen, doch jede Methode erfasst dann doch etwas ganz anderes. Wenn Sie sich dazu entscheiden, eine Messung manuell und nach festgelegter Methodik durchzuführen, sehen Sie z.B., was ein einzelner Kunde in einer frischen Browsersitzung sehen würde. Ein SaaS-Tool liefert Ihnen dafür Scores, die der Anbieter nach eigener Formel aus eigenen Abfragen bereitstellt.
Und dann gibt es noch die Option, eine API-Schnittstelle zu nutzen. Dabei läuft jede Abfrage des Modells über eine Schnittstelle, ohne dass Sie die typische Chat-Oberfläche verwenden müssen. Die API zeigt das jeweilige Modellverhalten unter den von Ihnen gewählten Einstellungen. Und damit kann die Messung von einer echten User-Sitzung mit Chat-Oberfläche abweichen.
Weil jeder dieser Ansätze andere Ergebnisse erzielen wird, gehört eine klar ausgewiesene Methodik neben jede Auswertung. Dazu zählt: Methode, System, Zeitraum, Stichprobe und die Anzahl der Wiederholungen. Nur so können später andere die Daten nachvollziehen und interpretieren.
Messen Sie also nun die KI-Sichtbarkeit Ihres Unternehmens von Hand, holen Sie sich ein Tool ins Haus, oder bauen Sie sich die Abfrage selbst über die Schnittstelle? In diesem Artikel vergleichen wir für SEO-Verantwortliche, Marketingmitarbeitende und Agentur-Teams drei Methoden. Wir zeigen, wie stark Antworten auf dieselbe Frage schwanken können, und geben am Ende eine Checkliste mit zehn Prüfpunkten, mit der Sie die Ergebnisse einordnen können.
Zur Wahrheit gehört dazu: auffindbar.ai bietet selbst KI-Sichtbarkeitsanalysen an und misst dafür laufend, weshalb wir in diesem Artikel kein einzelnes Werkzeug empfehlen. Dennoch sind wir um Transparenz bemüht: Jede Studie, die wir zitieren, nennen wir mit Herausgeber, und Herstellerstudien kennzeichnen wir im Quellenverzeichnis einzeln. Details zu unserer Quellenauswahl stehen im Methodik-Abschnitt am Artikelende.
Das Wichtigste in Kürze
- Eine manuelle Messung kommt dem, was Kunden in einer frischen Chat-Sitzung sehen, am nächsten. Ein SaaS-Tool liefert dafür deutlich längere Zeitreihen. Die API-Abfrage schafft viele Fragen in kurzer Zeit, kann aber andere Ergebnisse und Quellen liefern als die von Usern gewohnte Chat-Umgebung.
- Für die Messung von Markennennungen werden sieben Wiederholungen je Frage und Tag empfohlen, für Quellen mindestens acht (Preprint der Universität St. Gallen, 2026).
- Derselbe Prompt liefert selten das gleiche Ergebnis. In einer Studie von SparkToro und Gumshoe mit 2.961 Abrufen lag die Chance auf zweimal dieselbe Markenliste unter 1 zu 100.
- Zitierte Quellen wechseln stärker als genannte Marken: Von Tag zu Tag stimmten 34 bis 42 Prozent der Quellen überein, bei den Marken 45 bis 59 Prozent.
- Bei 30 Treffern in 78 Abfragen liegt der wahre Wert mit 95 Prozent Sicherheit zwischen 28 und 50 Prozent.
Welche Methode beantwortet welche Frage?
Erinnern Sie sich an die Frage vom Anfang, ob die ChatGPT-Antwort nun Zufall war? Welche Methode Ihnen die Antwort liefert, hängt davon ab, was genau Sie wissen wollen. Diese Übersicht zeigt, welche Frage jede Methode beantwortet und was sie dabei tatsächlich misst.
| Ich will wissen … | Methode | Sie misst eigentlich … |
|---|---|---|
| Was sehen meine Kunden in ihrer eigenen Sitzung? | Manuelle Messung | Die Kundensicht einer frischen, einzelnen Sitzung |
| Wie entwickelt sich unsere Auffindbarkeit über Wochen? | SaaS-Tool | Scorings, die der Hersteller nach eigener Formel aus eigenen Abfragen berechnet |
| Wie beantwortet ein KI-Modell ohne Chat-Oberfläche, möglichst viele Abfragen in sehr kurzer Zeit? | API-Abfrage | Das Modellverhalten unter den von Ihnen gewählten Einstellungen, das von der Chat-Oberfläche abweichen kann |
1. Wie misst man KI-Sichtbarkeit 2026?
Sie messen KI-Sichtbarkeit von Hand, mit einem Tool im Abo oder per API-Abfrage. Jede Variante hat ihren eigenen Aufwand und ihre eigene Kontrolle, und am Ende zählt sie etwas anderes, wie die folgende Tabelle zeigt.
| Methode | Geeignet für | Stärke | Mögliche Schwäche | Was Sie dokumentieren müssen |
|---|---|---|---|---|
| Manuelle Messung (frische Sitzung, Codebook: schriftliche Regeln, wie eine Antwort in Zählwerte übersetzt wird) | Studien, Ausgangsmessungen, Prüfung einzelner Fragen | Volle Kontrolle, Originalantworten archivierbar | Hoher Aufwand, wenige Wiederholungen | System, Modellvariante, Datum, Standort, Login, Wortlaut der Frage, vollständiger Antworttext |
| Messwerkzeug im Abo | Laufende Beobachtung vieler Fragen | Regelmäßige Wiederholung, Verlauf über Wochen | Abfrage und Rechenweg legt der Hersteller fest | Wie das Werkzeug abfragt, wie die Kennzahl berechnet wird, welche Fragen laufen, wie oft pro Tag |
| API-Abfrage (eigene Skripte) | Technische Teams mit großem Fragenvolumen | Viele Fragen, jederzeit wiederholbar | Kann von der Chat-Oberfläche abweichen | Modell, Einstellungen, Websuche an oder aus, Systemanweisung |
Sie müssen sich dabei nicht für eine einzige Methode entscheiden. Eine manuelle Stichprobe eignet sich gut als Gegenprobe, sie zeigt, ob ein Werkzeug oder ein eigenes Skript wirklich dasselbe misst wie die Chat-Oberfläche Ihrer Kunden. Was die Werkzeuge dafür kosten, lesen Sie im Artikel „Was kostet GEO 2026?”.
2. Was genau wird gemessen?
Wer zum ersten Mal ein KI-Sichtbarkeits-Dashboard öffnet, sieht meist eine vordefinierte Gruppe von Kennzahlen und hält sie für eindeutig. Dabei stecken darin mindestens drei verschiedene Angaben, und jede einzelne muss in ihrer Tiefe verstanden werden: die Nennung im Antworttext, die Quelle in der Quellenliste und die sichtbare Zitation direkt an der Aussage.
| Was gezählt wird | Frage dahinter | Beispiel aus einem Messprotokoll |
|---|---|---|
| Nennung | Kommt die Marke im Antworttext vor? | Lauf R-0022 (ChatGPT): sieben Anbieter genannt |
| Quelle angegeben | Steht eine Seite der Marke in der Quellenliste? | Lauf R-0043: Eine Quelle stand nur in der Liste und gehörte zu keiner Nennung. Sie wurde fälschlich einer Nennung zugeordnet, die Zuordnung wurde korrigiert |
| Sichtbar zitiert | Hängt an der Aussage ein Link, der sie stützt? | Lauf R-0022: Einen Link an der Aussage gab es für vier der sieben Anbieter |
Selbst der Name einer Kennzahl verrät nicht, wie sie berechnet wird. Bei „Sichtbarkeit” teilt ein Hersteller die Antworten mit Marke durch alle Antworten, ein anderer durch die Zahl der Fragen. Beim Share of Voice (dem Anteil einer Marke an allen Nennungen) teilt einer Nennungen durch Nennungen, ein anderer zählt im Zähler Antworten. Das geht aus den öffentlichen Beschreibungen der Hersteller hervor. Fragen Sie deshalb vor jedem Vergleich, was im Zähler und was im Nenner steht.
Noch unzuverlässiger als die Kennzahl selbst ist die Position in einer Liste. SparkToro und Gumshoe (Januar 2026) fanden nach Angabe der Autoren dieselbe Reihenfolge etwa einmal in 1.000 Abrufen. In einer Beispielauswertung mit mehreren Systemen stammten 71 von 86 Rangangaben aus ChatGPT, weil Gemini und Google AI Overviews kaum Ranglisten ausgeben. Aussagen über Positionen gelten deshalb nur für ein System.
3. Wie funktioniert eine manuelle Messung?
Bei der manuellen Messung tun Sie genau das, was am Artikelanfang beschrieben ist: Sie geben eine Frage in einen Chat ohne Verlauf ein und schreiben penibel auf, was erscheint. Systematisch betrieben bleibt das Prinzip gleich, nur dass Sie jede Antwort im Original speichern und nach schriftlichen Regeln in Zählwerte übertragen. Ein Beispielprotokoll zeigt, wie die Dokumentation dafür aussehen kann.
- Fragen. 26 Fragen aus neun typischen Situationen einer Kaufentscheidung. Keine nennt eine Marke. Jede wurde vorab auf Neutralität geprüft und eingefroren, also vor der Messung nicht mehr verändert.
- Systeme und Stichprobe. ChatGPT, Gemini und Google AI Overviews, jede Kombination einmal: 78 Abfragen.
- Bedingungen. Frische Sitzung ohne Verlauf, Personalisierung abgeschaltet, fester Standort. ChatGPT und Gemini liefen mit einem angemeldeten kostenlosen Konto, Google AI Overviews abgemeldet.
- Belege. Zu jeder Abfrage liegen Antworttext, Wortlaut der Frage, Modellbezeichnung und Screenshots vor.
- Codierung. Ein Fünftel der Antworten wurde ein zweites Mal ausgewertet, um die Übereinstimmung zu messen.
- Datenprüfung. In acht Durchgängen wurde jede Abfrage mit dem gespeicherten Antworttext abgeglichen: Sechs Abfragen mussten korrigiert werden, 72 waren ohne Befund. Bei zwei Abfragen zeigte Google keine AI Overview an. Sie blieben im Nenner.
Wer wissen will, was Kunden tatsächlich sehen, kommt an dieser Methode nicht vorbei. Sie schafft nur so viele Wiederholungen, wie Sie von Hand durchhalten.
4. Was leisten Messwerkzeuge im Abo, und was nicht?
Wer schon einmal ein neues Software-Tool im Team eingeführt hat, kennt das Gefühl der ersten Tage. Die Zahlen auf dem Dashboard wirken sofort überzeugend, aber wie sie im Hintergrund berechnet werden, bleibt zunächst unklar. Dazu kommen unzählige Dimensionen, die es anzuschauen und auszuwerten gilt. Bei Messwerkzeugen für KI-Sichtbarkeit ist das nicht anders. Ein solches Werkzeug stellt Ihre Fragen regelmäßig und zeigt den Verlauf, doch wie es abfragt und rechnet, legt allein der Anbieter fest. Genau das sollten Sie prüfen, bevor Sie sich auf die Zahl verlassen.
Laut den öffentlichen Beschreibungen der Anbieter kommen die Antworten auf vier Wegen zustande: per Browser-Automatisierung aus der Chat-Oberfläche, per reiner API-Abfrage, per API-Abfrage mit nachgebautem Gesprächsverlauf oder gemischt (eine KI über die API, die übrigen über die Oberfläche). Das sind Selbstauskünfte. Eine unabhängige Prüfung haben wir nicht gefunden.
Wichtig!
Prüfen Sie bei jedem Tool fünf Dinge:
- den Weg, auf dem die Antworten kommen,
- wie oft jede Frage pro Tag läuft,
- was bei jeder Kennzahl im Zähler und im Nenner steht,
- von welchem Standort abgefragt wird
- und ob Sie die vollständigen Antworttexte einsehen können.
Ohne sie lässt sich kein Wert nachzählen.
Die Auswahl der Prompts nehmen Ihnen manche Tools ab. Hersteller empfehlen 20 bis 40, 30 bis 50 oder rund 100 Fragen je Thema zu stellen. Aus unserem Agenturalltag wissen wir: Wichtiger ist die strategische Vorüberlegung: Welche Produkte oder Services wollen wir direkt in ihrer Auffindbarkeit verbessern? Oder geht es um die generelle Unternehmenswahrnehmung?
Allein diese Frage bestimmt, wie sich Ihr Prompt-Set insgesamt zusammensetzt.
5. Wann ist eine API-Abfrage sinnvoll?
Technisch versierte Teams kommen bei dieser dritten Methode schnell auf eine naheliegende Idee, nämlich die Schnittstelle selbst anzubinden und sich die Klickarbeit in der Chat-Oberfläche zu sparen. Eine API-Abfrage lohnt sich, wenn Sie sehr viele Fragen per Skript stellen wollen und die Einstellungen selbst festlegen können. Ob ihre Antworten aber denen entsprechen, die Ihre Kunden in der Chat-Oberfläche tatsächlich sehen, ist umstritten.
Für eine Abweichung spricht eine Studie des Herstellers Surfer (Stand der Seite: 25. September 2026, Daten vom 4. August 2026) mit 1.000 Fragen und 13.779 Antworten. Die genannten Marken stimmten nur zu 15,5 bis 23,8 Prozent überein. ChatGPT nannte über die API im Schnitt 13,8 Marken pro Antwort, in der Chat-Oberfläche 7,9, und führte dort 12,1 Quellen an, über die API 3,1. Die Seite liegt in zwei Fassungen mit unterschiedlichen Zahlen vor. Geben Sie deshalb Fassung und Stand an. Gumshoe widerspricht: Die Studie zeige nur, dass die Standardeinstellungen der API abweichen, nicht, dass sich die Oberfläche per API nicht nachbilden lässt. Beide Seiten verkaufen Messlösungen.
Die Dokumentation von OpenAI, Anthropic und Google erklärt einen Teil des Unterschieds: Das Modell entscheidet selbst, ob es im Web sucht, sofern Sie die Suche nicht erzwingen. In einem Preprint vom September 2026 (Amani u. a.) suchte ein getestetes Modell bei 14 Prozent der Fragen, ein anderes bei 83 Prozent. Ein Mitarbeiter von Perplexity schrieb im April 2026 im Community-Forum, die Web-Version suche in mehreren Stufen, ein Standard-API-Aufruf in einer.
Unser Rat:
Vergleichen Sie eine API-Messung vor dem ersten Einsatz mit einer manuellen Stichprobe und halten Sie bei jedem Abruf Modell, Einstellungen und Suchstatus fest.
6. Wie oft muss man dieselbe Frage stellen?
Erinnern Sie sich an das Beispiel aus Abschnitt 3, bei dem jede Frage nur einmal lief? Genau das reicht laut aktueller Forschung nicht aus. Für die Nennung einer Marke werden sieben Abrufe je Frage und Tag, für Quellen mindestens acht empfohlen. Das ist die einzige Zahl, die wir in einer Studie mit offengelegter Methode gefunden haben.
Die Studie heißt „Don’t Measure Once” (Schulte, Bleeker und Kaufmann, Universität St. Gallen, arXiv, April 2026). Die Autoren simulierten die Messung mehrfach mit neu gezogenen Stichproben (Bootstrap-Analyse). Bei sieben Abrufen sinkt die Schwankung der Erkennungsrate einer Marke unter 0,10, bei Quellen ab acht. Grundlage sind 32 deutschsprachige Fragen, vier Systeme (ChatGPT, Gemini, Google AI Mode, Perplexity) und Abfragen von Servern in der Schweiz zwischen dem 24. Januar und dem 20. März 2026. Die Studie ist ein Preprint ohne bestätigte Begutachtung, ein Autor arbeitet zusätzlich bei einem Unternehmen, und zum Login-Zustand macht sie keine Angabe.
Andere Studien beantworten andere Fragen:
| Quelle | Frage | Zahl | Hinweis |
|---|---|---|---|
| Schulte u. a. (Hochschul-Preprint, 2026) | Ab wann ist die Nennungsrate pro Marke stabil? | 7 Abrufe (Marken), 8 (Quellen) je Frage und Tag | Mittelwert über viele Marken, nicht für eine einzelne Marke zitieren |
| SparkToro und Gumshoe (Herstellerstudie, Januar 2026) | Wie oft muss man fragen, um die ganze Empfehlungsliste zu kennen? | „usually at least 60-100X" | 600 Freiwillige, 12 Fragen, 2.961 Abrufe. Login, Verlauf und Standort nicht kontrolliert |
| Rankfor.AI (Preprint, Autor ist Geschäftsführer eines Messwerkzeug-Herstellers) | Wann sind alle Marken gefunden? | Nach zehn Aufrufen waren 92,6 bis 95,2 Prozent der Marken aus 15 Aufrufen wiedergefunden | „does not establish a universal stopping rule". Auswertung mit KI-Annotation |
Die Zahlen widersprechen sich nicht, weil die Studien Verschiedenes wissen wollen. Wer eine Nennungsrate schätzen will, kommt mit wenigen Abrufen je Frage aus. Wer wissen will, welche Marken überhaupt vorkommen können, braucht viele. Ein Hersteller rät in einer Studie vom September 2026 bei festem Budget zu mehr verschiedenen Fragen statt zu mehr Wiederholungen derselben Frage. Das ist nicht begutachtet, spricht aber dafür, Zahl der Fragen und Zahl der Wiederholungen getrennt zu planen.
7. Welche Rolle spielen Standort, Zeitpunkt, Login und Modellversion?
Wer eine Messung über mehrere Wochen wiederholt, bemerkt schnell, dass dieselbe Frage nicht nur innerhalb eines Tages unterschiedliche Antworten liefert. Sie verändert sich auch mit Standort, Zeitpunkt, Login-Status und Modellversion. Alle vier Faktoren beeinflussen die Antwort, aber nur für zwei davon gibt es belastbare Messwerte:
- Modellversion. SISTRIX wertete 3,8 Millionen deutschsprachige ChatGPT-Antworten aus. Nach dem Start von GPT-5.5 am 23. Mai 2026 verschoben sich die Zitationen innerhalb von 48 Stunden um 47 Prozent, die übliche Tagesschwankung liegt laut SISTRIX bei 1 bis 2 Prozent. Der Herausgeber verkauft Prompt-Tracking, also die regelmäßige Abfrage vorgegebener Fragen.
- Zeitpunkt. Ahrefs fand bei Google AI Overviews eine Wahrscheinlichkeit von 70 Prozent, dass sich der Text zwischen zwei Beobachtungen ändert, und 45,5 Prozent der zitierten Quellen waren neu (43.000 Suchbegriffe, November 2025). Ein Datensatz eines Herstellers mit zwei identischen Abrufen ergab bei ChatGPT eine Übereinstimmung der Marken von 69 Prozent, bei Gemini von 40,7 Prozent.
- Standort. OpenAI schreibt im Help Center, ChatGPT könne einen ungefähren Standort aus der IP-Adresse nutzen, nennt aber keine Wirkung. Die einzige Messung, die wir fanden, ist eine kleine US-Studie eines Herstellers mit 279 Antworten an einem Tag. Für den deutschsprachigen Raum fehlt bislang eine vergleichbare Untersuchung.
- Login und Personalisierung. OpenAI beschreibt eine Memory-Funktion, die Vorlieben und Orte speichert. Eine Studie zum Unterschied zwischen angemeldet und abgemeldet haben wir nicht gefunden.
Halten Sie alle vier Faktoren bei jeder Messung fest. Dann können Sie später ausschließen, dass ein Unterschied nur auf einen von ihnen zurückgeht.
8. Welche Zahlen kann man veröffentlichen?
Ob ein Prozentwert verlässlich ist, hängt von mehr ab als von der Zahl allein: von der Stichprobengröße und von der Übereinstimmung zwischen den Prüfern. Sie können einen Wert oder eine Aussage veröffentlichen, wenn Sie jede der zehn Fragen dieser Checkliste mit Ja beantworten können. Fehlt eine Antwort, geben Sie die Zahl nur als Momentaufnahme mit Vorbehalt an. Die rechte Spalte zeigt anhand eines Beispiels, wie sich die Fragen beantworten lassen.
| Nr. | Checkfrage | Beispielantwort |
|---|---|---|
| 1 | Stand das Set an Fragen vor der Messung fest und wurde es danach nicht mehr verändert? | Ja. Die Fragen wurden vorab auf Neutralität geprüft und danach eingefroren. |
| 2 | Nennt keine der Fragen eine Marke, oder werten Sie markennennende Fragen (branded Prompts) getrennt aus? | Ja. Keine der Fragen nennt eine Marke. |
| 3 | Sind System, Modellvariante, Datum, Standort und Login-Zustand zu jeder Abfrage dokumentiert? | Ja. Für jede Abfrage einzeln dokumentiert. |
| 4 | Lief die Messung in einer frischen Sitzung ohne Verlauf, mit abgeschalteter Personalisierung? | Ja, so gemessen. |
| 5 | Sind die Originalantworten gespeichert? | Ja. Antworttext und Screenshots zu jeder Abfrage. |
| 6 | Wurden die Zahlen aus den Einzelantworten nachgezählt statt übernommen? | Ja, in diesem Beispiel mussten sechs von 78 Abfragen korrigiert werden. |
| 7 | War die Zahl der Wiederholungen je Frage vorab festgelegt? | Nein. In diesem Beispiel lief jede Frage nur einmal. |
| 8 | Sind die Codierregeln schriftlich festgehalten, wurde eine Stichprobe doppelt ausgewertet und die Übereinstimmung berichtet? | Ja. Codebook vorhanden, ein Fünftel der Antworten zweimal ausgewertet, die Übereinstimmung lag bei 0,64. |
| 9 | Sind Nennung, Quellenangabe und sichtbare Zitation getrennt ausgewiesen? | Ja. Drei getrennte Zählungen, siehe Abschnitt 2. |
| 10 | Steht der methodische Vorbehalt bei jeder Zahl, auch in Auskopplungen für Social Media oder Presse? | Ja. Rohzahl neben dem Prozentwert, mit Hinweis auf Momentaufnahme. |
Die Checkliste ist eine Arbeitshilfe und kein Standard.
9. Wann reicht eine manuelle Stichprobe nicht?
Eine manuelle Stichprobe reicht nicht, wenn Sie Veränderungen über die Zeit belegen, mehrere Märkte vergleichen oder Wahrscheinlichkeiten angeben wollen. Dafür fehlen ihr Wiederholungen, und ohne sie lässt sich die Streuung nicht messen. Sie betrachten und beschreiben damit den Zustand zu einem Zeitpunkt, nicht aber die Entwicklung.
Auch ein Tool ersetzt diese Stichprobe nicht! Eine API-Messung ersetzt sie erst, wenn belegt ist, dass die API-Antwort der Antwort in der Chat-Oberfläche entspricht.
10. Welche Fehler passieren am häufigsten?
Aus eigener Projekterfahrung und aus weiteren Studien lassen sich sieben typische Fehler ableiten, die bei einer manuellen Messung leicht passieren.
- Ein Durchlauf statt Wiederholungen. Laufen alle Abfragen nur einmal, beschreiben die Prozentwerte daraus einen einzelnen Abruf und keine Wahrscheinlichkeit.
- Quellen nicht bereinigt. ChatGPT hängt an Quell-Adressen häufig den Zusatz „utm_source=chatgpt.com” an. Entfernen Sie ihn nicht, zählt dieselbe Seite mehrfach.
- Quellenliste als Beleg für die Nennung gelesen. Steht eine Quelle nur in der Liste, ohne eine konkrete Aussage im Text zu stützen, wird sie trotzdem leicht als Beleg für eine Nennung mitgezählt. Prüfen Sie jede Zuordnung einzeln, bevor Sie sie werten.
- Verschiedene Zählungen vermischt. Bei Google AI Overviews stammen Quellen oft aus zwei verschiedenen Listen: einer mit Bezug zur Empfehlung und einer aus Kartendienst-Ansichten. Wer beide ungetrennt als Zitationen zählt, überzeichnet das Ergebnis.
- Brutto und netto verwechselt. Taucht dieselbe Marke in Tabelle, Kategorien und einer Top-Liste gleichzeitig auf, ergeben sich mehr Platzierungen als tatsächlich genannte Anbieter. Zählen Sie Anbieter und Platzierungen deshalb getrennt.
- Kontrollzahl mit Eingabe verwechselt. Eine von Hand eingetippte Kontrollzahl wie „78 von 78 Abfragen erfasst” bestätigt nur die Eingabe und nicht die Daten. Lassen Sie solche Summen aus den verknüpften Zeilen berechnen statt sie einzutippen.
- Vergleichsgruppe nachträglich verändert. Wächst die Vergleichsliste, weil Einrichtungen erst aufgenommen werden, nachdem ein System sie genannt hat, ist das eine Auswahl nach dem Ergebnis. Vergleiche über eine so gewachsene Gruppe laufen im Kreis.
Prüfen Sie außerdem, ob die angegebenen Adressen erreichbar sind. In einem Preprint (Rao, Wong und Callison-Burch, April 2026) waren 3 bis 13 Prozent der Quellenangaben erfunden und 5 bis 18 Prozent nicht auffindbar, jeweils bei Modellen mit Suchfunktion.
11. Wie wählen Sie die Methode?
Welche Methode zu Ihrer Frage passt, steht in der Übersicht vom Artikelanfang. Zwei weitere Kriterien entscheiden aber noch, bevor Sie sich endgültig festlegen.
- Haben Sie Entwickler im Team und können die Einstellungen der Abfrage selbst festlegen? Dann lohnt die API. Fehlt eines von beiden, fahren Sie mit der Chat-Oberfläche besser.
- Wollen Sie die Zahl veröffentlichen? Dann braucht sie die Checkliste aus Abschnitt 8, egal mit welcher Methode sie entstanden ist.
| Rolle | Empfehlung | Begründung |
|---|---|---|
| Marketingleitung | Manuelle Stichprobe, dann entscheiden | Geringster Aufwand, liefert eine Ausgangslage für die Budgetfrage |
| SEO- und Performance-Verantwortliche | Messwerkzeug plus manuelle Gegenprobe | Verlauf über Wochen, und Sie kontrollieren die Methode des Herstellers |
| Agenturinhaber oder Teamlead | Dokumentiertes Protokoll mit Checkliste für alle Kunden | Vergleichbare Zahlen über Kunden hinweg, Argumentationsbasis im Pitch |
| Medien- und Branchenkontakte | Nur Zahlen mit Methodenangabe weitergeben | Rückfragen zur Methode sind die Regel |
Fazit: Was nehmen Sie mit?
Zurück zur Frage vom Anfang. Ob Ihr Unternehmen zufällig oder aus gutem Marketing heraus in einer ChatGPT-Antwort auftaucht, lässt sich nicht mit einer einzigen Zahl beantworten. KI-Sichtbarkeit lässt sich messen, aber jede Methode misst etwas anderes. Die belegbare Untergrenze für eine Markennennung liegt bei sieben Abrufen je Frage und Tag, für Quellen bei acht, und auch das beruht auf einem Preprint. Wie stark Chat-Oberfläche, Messwerkzeug und API voneinander abweichen, wissen wir nur aus Studien von Herstellern, die ihre eigene Methode verkaufen. Schreiben Sie deshalb Methode, System, Zeitraum, Stichprobe und Wiederholungszahl neben jede Zahl, die Sie weitergeben, und zählen Sie aus den gespeicherten Antworttexten nach.
Sie wollen GEO für Ihr Unternehmen jetzt umsetzen, fragen sich aber, mit welchen Kosten Sie rechnen müssen? Dazu haben wir einen ausführlichen Ratgeber mit Marktdaten geschrieben, der Preise für Tools, Agenturen und Eigenleistung vergleicht: „Was kostet GEO 2026?”.
Häufige Fragen
Wie misst man KI-Sichtbarkeit?
Von Hand in frischen Sitzungen, mit einem Messwerkzeug im Abo oder per API-Abfrage. Jede Methode misst etwas anderes, deshalb gehört die Methode zu jeder Zahl.
Wie oft muss ich dieselbe Frage stellen?
Für die Nennung einer Marke mindestens sieben Abrufe je Frage und Tag, für Quellen mindestens acht (Preprint der Universität St. Gallen, 2026). Wer die vollständige Empfehlungsliste kennen will, braucht laut SparkToro 60 bis 100 Abrufe.
Zeigen Messwerkzeuge dasselbe wie ChatGPT?
Das hängt vom Weg ab, auf dem das Werkzeug die Antworten holt. Eine Studie des Herstellers Surfer fand bei API-Antworten deutlich andere Marken und Quellen als in der Chat-Oberfläche. Prüfen Sie ein Werkzeug mit einer manuellen Stichprobe.
Ist eine API-Abfrage genauso gut wie die Chat-Oberfläche?
Das ist nicht belegt. Die KI-Hersteller dokumentieren, dass das Modell selbst entscheidet, ob es im Web sucht.
Spielt der Standort eine Rolle?
OpenAI bestätigt, dass ein ungefährer Standort aus der IP-Adresse einfließen kann. Wie stark das im deutschsprachigen Raum wirkt, ist nicht gemessen.
Hat der Login-Zustand Einfluss?
Wir haben keine Studie dazu gefunden. Halten Sie den Zustand trotzdem bei jedem Abruf fest.
Warum sind Prozentwerte unsicher?
Kleine Stichproben haben breite Intervalle. Bei 30 Treffern in 78 Abfragen liegt der wahre Wert mit 95 Prozent Sicherheit zwischen 28 und 50 Prozent.
Kann ich eine Position in der Antwort messen?
Nur eingeschränkt. Die Reihenfolge einer Markenliste wiederholte sich in der Studie von SparkToro und Gumshoe in etwa einem von 1.000 Abrufen. Positionsdaten gelten nur für ein System.
Quellen und Methodik
Alle Quellen abgerufen am 5. Oktober 2026. Quellen von Herstellern von Messwerkzeugen oder von Beratungen, die Messungen verkaufen, sind mit „Hersteller” gekennzeichnet, das trifft auf die meisten der zitierten Studien zu. Wo es ging, stützen wir die Kernaussagen stattdessen auf Hochschul-Preprints (veröffentlichte Studien ohne unabhängige Begutachtung) und auf die Dokumentation der KI-Hersteller selbst. Eine begutachtete Studie zur nötigen Wiederholungszahl haben wir trotz Suche nicht gefunden.
- Schulte, Bleeker, Kaufmann: Don’t Measure Once: Measuring Visibility in AI Search (GEO). Preprint, Universität St. Gallen, arXiv:2604.07585, April 2026, arxiv.org (Hochschule, ein Autor zusätzlich bei einem Unternehmen)
- SparkToro und Gumshoe (Rand Fishkin): New Research: AIs are highly inconsistent when recommending brands or products. 27. Januar 2026 (Hersteller), sparktoro.com
- Rankfor.AI: Preprint, arXiv:2609.05059, 11. September 2026 (Autor bei einem Hersteller), arxiv.org
- Ahrefs: AI Overviews Change Every 2 Days. 11. November 2025 (Hersteller), ahrefs.com
- SISTRIX: ChatGPT Core Updates. 29. Mai 2026, aktualisiert 21. August 2026 (Hersteller), sistrix.de
- Surfer: Scraped AI Answers vs. API Results from LLMs. Stand der Seite 25. September 2026 (Hersteller), surferseo.com
- Gumshoe: How APIs unlock better insights into AI search visibility. 20. Januar 2026 (Hersteller), gumshoe.ai
- Rao, Wong, Callison-Burch: Reference Hallucinations. Preprint, arXiv:2604.03173, April 2026, arxiv.org
- Amani u. a.: Characterizing Web Search by Conversational LLM Agents. Preprint, arXiv:2609.19244, 16. September 2026, arxiv.org
- OpenAI: Web search tool (Entwicklerdokumentation), developers.openai.com
- Anthropic: Web search tool, platform.claude.com
- Perplexity Community: PerplexityPro response vs SonarPro response, Antwort eines Mitarbeiters, 7. April 2026, community.perplexity.ai
- OpenAI Help Center: Searching the web with ChatGPT, help.openai.com
- OpenAI Help Center: Memory FAQ, help.openai.com
- Landis, Koch (1977): The measurement of observer agreement for categorical data. Biometrics 33(1), 159 bis 174, doi.org
- McHugh (2012): Interrater reliability: the kappa statistic. Biochemia Medica 22(3), 276 bis 282, doi.org
- Wilson (1927): Probable inference, the law of succession, and statistical inference. Journal of the American Statistical Association 22(158), 209 bis 212